繰り返し測定がどれぐらい検出力を上げるのか
経時データ解析のパワーについて以前のブログで少し話題にしましたが、
このトピックで面白い論文を見たのでご紹介
この論文では、二群間の差を比較する研究において、測定の繰り返し数が症例数に与える影響について検討しています。
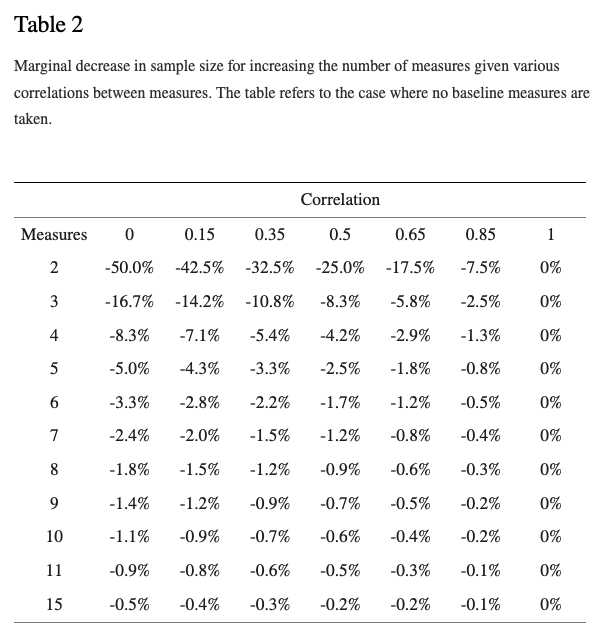
測定間の相関係数が1に近くなる(測定結果がほとんど変わらない)と、繰り返し測定する意味がなくなりますので症例数を少なくすることもできません(0%に近くなります)。一方で測定間の相関係数が低い(値がばらつく)場合は、測定を繰り返すことで平均の精度が上がるので、症例数を減らすことができるということが示されています。
上記はBaseline測定なしの繰り返し測定ですが、Baselineのデータも測定しているともう少し症例数を減らせて、下記のような結果です。(このシミューレーションは、測定間の相関係数が割合低い(0.5)です。
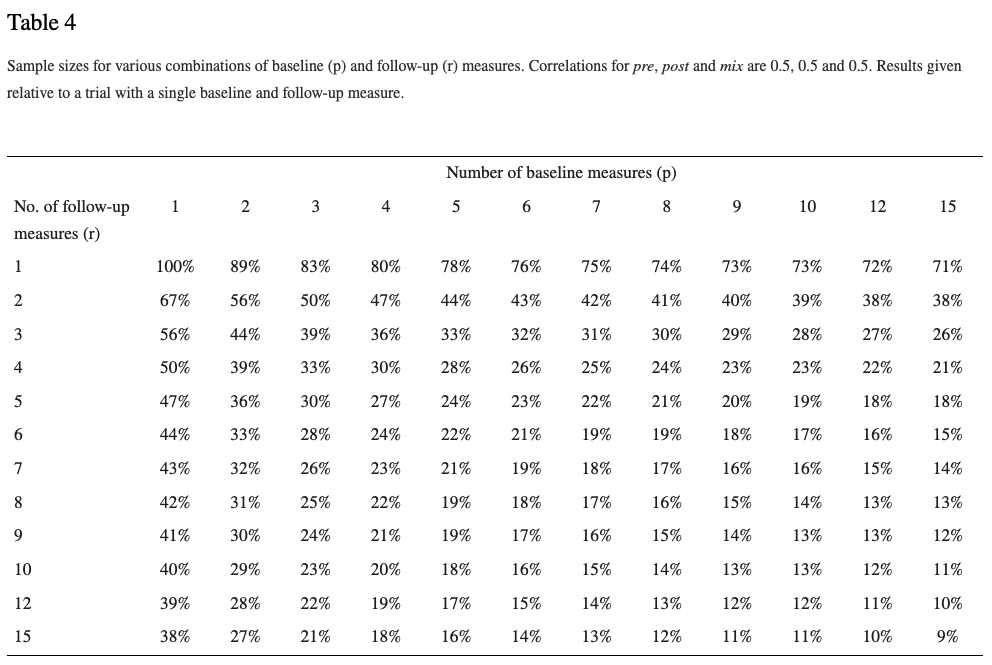
ただ、臨床指標や検査値などはある程度測定間のばらつきは抑えられているでしょうから、現実的な設定としては症例数を半分ぐらいに減らすことができれば十分という気がします。
著者のおすすめは、繰り返し測定のコストにもよりますが、Baseline4回、Follow-upで7回ぐらいで十分なのではないかと言う事でした。
私もある検査値を経過中に繰り返し測定したデータを解析しています。二群間の変化の差を取るには経時的な繰り返し測定は必須なのですが、平均の差については、検出力に与える影響はこのようにあまり大きくないようです。縦断研究は横断研究と比較してオペレーションコストが10倍ぐらいかかる気がしますので、平均の差に興味があるのであれば、横断研究の症例数を増やすほうが安上がりではないかと最近は思っています。
経時データ解析のパワー
経時データ解析の検出力を計算する必要があったので調べました
同一個体内での繰り返し間で変化する因子の効果を調べる場合には(時間に対する傾きや、投与前後での繰り返し測定など)、繰り返し間の相関(rho)が少ないほうが有利です。
alpha = 0.05
power = 0.8
t = c(0, 0.5, 1, 1.5, 2) # time points for repeated measurements
rho = 0.2 # correlation between repeated observations
Sig2 = 100 # measurement variation
d = 0.5 # difference between groups
# calculation
Z_a = qnorm(1-alpha) # if two sided, Z_a = qnorm(1-alpha/2)
Z_b = -qnorm(1-power)
n = length(t)
Sx2 = var(t)*(n-1)/n # within individual variance of t
N_group = 2 * (Z_a + Z_b)^2 * Sig2 * (1 - rho) / n / Sx2 / d^2
上記は繰り返し間の相関がrho1つだけ(Exchangeable)の相関構造のモデルの例ですが、好きな相関構造Rとデザイン行列Xに対して、
t(X) %*% solve(R) %*% X
から、興味のある部分の分散をとってSig2 * (1 - rho) / n / Sx2と置き換えることでそちらも計算できます。複雑になるなら"longpower"というRのパッケージが使いやすいかもしれません。
一方、繰り返し間では変化しない因子の効果を調べる際には(最初に投与群と非投与群を設定して、その両群の平均の差を調べる場合など)、繰り返し間の相関が強すぎる場合は繰り返し測定の意味がありませんので、逆に必要症例数が多くなります。
N_group = 2 * (Z_a + Z_b)^2 * Sig2 * (1 + (n- 1) * rho)) / n / d^2
なおN_groupは一群あたりの人数です。
参考にしたのは下記の本です。
Analysis of Longitudinal Data (Oxford Statistical Science Series) 2nd Ed p29
固有値分解と行列の階乗
一般線形最小二乗法を使うために行列を固有値分解して、-0.5乗などの行列を求める必要があり、このあたりをどうするかを調べました。 Rには、eigenというFunctionがあります。
> A = matrix(c(1,2,3,2,3,4,3,4,5), ncol = 3)
> A
     [,1] [,2] [,3]
[1,]    1    2    3
[2,]    2    3    4
[3,]    3    4    5
> eigen(A)
eigen() decomposition
$values
[1]  9.623475e+00 -1.887379e-15 -6.234754e-01

$vectors
           [,1]       [,2]       [,3]
[1,] -0.3850898  0.4082483  0.8276709
[2,] -0.5595102 -0.8164966  0.1424137
[3,] -0.7339306  0.4082483 -0.5428436
この出力を使って、
この形に分解してくれます。
> P = eigen(A)$vector
> D = diag(eigen(A)$values)
> invP = solve(P)
> P %*% D %*% invP
     [,1] [,2] [,3]
[1,]    1    2    3
[2,]    2    3    4
[3,]    3    4    5
なお、Aが分散共分散行列などのような対称行列であれば、
なので、solve(A) を t(A)にすることで計算量は減ります。
とにかく、固有値分解をする意味は、行列の階乗が簡単にできることです。例えばAの3乗は
> A %*% A %*% A
     [,1] [,2] [,3]
[1,]  132  192  252
[2,]  192  279  366
[3,]  252  366  480

> P %*% D^3 %*% invP
     [,1] [,2] [,3]
[1,]  132  192  252
[2,]  192  279  366
[3,]  252  366  480
で計算できます。下記のようなFunctionをつくっておくのも良いかもしれません。
> "%^%" <- function(x, n){
+   with(eigen(x), vectors %*% (values^n * solve(vectors)))
+ }
> A %^% 3
     [,1] [,2] [,3]
[1,]  132  192  252
[2,]  192  279  366
[3,]  252  366  480
この関数で、Aの半乗(0.5乗)を求めました。
> A = matrix(c(2,2,3,4,5,3,2,3,5), ncol = 3)
> A
     [,1] [,2] [,3]
[1,]    2    4    2
[2,]    2    5    3
[3,]    3    3    5
> B = A %^% 0.5
> B
          [,1]      [,2]      [,3]
[1,] 1.0577617 1.2406827 0.3642050
[2,] 0.4495838 2.0309631 0.6886054
[3,] 0.8878226 0.4609286 2.0878823
> B %*% B
     [,1] [,2] [,3]
[1,]    2    4    2
[2,]    2    5    3
[3,]    3    3    5
Rでの生存時間解析(時間変化共変量の処理)
今回は生存時間解析について。
フォローアップ中に、喫煙から非喫煙になったり、運動習慣が変化したり、などとアウトカムに関係のある変数が変化した時に、どう対応すればよいのでしょうか。このように、変化しうる共変量をTime varying covariates / time dependent covariates (時間依存共変量?時間変化共変量?)と言います。
じつは、Survival Analysisにとっては、この時間依存性の共変量の処理は大きく変わったことをしているわけではありません。そのあたりを示せればと思います。 まず、下記のRコードを走らせます。
# Settings
library(survival)
library(rms)

# Data generation
set.seed(1)
test = data.frame(id=1:400,
                  start=sample(1:100, 400, replace = T),
                  stop =sample(105:400, 400, replace = T),
                  outcome=c(rbinom(200, 1, prob=0.1), rbinom(200, 1, prob=0.2)),
                  treat = c(rep(0, 200), rep(1, 200)),
                  smoke = c(sample(0:1, 400, replace = T))) # smoke indicator

# Data processing
test$ptime    = test$stop - test$start # person time
test$SurvObj1 = with(test, Surv(ptime, outcome == 1)) # using person time
test$SurvObj2 = with(test, Surv(start, stop, outcome == 1)) # using start-stop
test$SurvObj3 = with(test, Surv(rep(0,400), ptime, outcome == 1)) # using 0-ptime
head(test)

# KM curve and ploting
model1 = survfit(SurvObj1 ~ treat, data = test)
## for survplot (survplot has more options)
## model1.1 <- npsurv(SurvObj ~ trea+smoke, data = test, conf.type = "log-log") ;survplot(model1.1)
model2 = survfit(SurvObj2 ~ treat, data = test)
model3 = survfit(SurvObj3 ~ treat, data = test)
par(mfcol=c(1,3))
plot(model1)
plot(model2)
plot(model3)


# Cox proportional hazarmodel
coxph(SurvObj1 ~ treat + smoke, data=test)
coxph(SurvObj2 ~ treat + smoke, data=test)
coxph(SurvObj3 ~ treat + smoke, data=test)
下記の条件でSurvobjに対して、KM曲線を書きます。
SurvObj1はsurvival特有のデータで、ここでは単純にstartとstopの差(人時間)を取っています。(model1)
SurvObj2は人時間自体は同じですが、start timeとstoptimeを残しています。(model2)
- SurvObj3はstart timeをすべて0にして、stoptimeは0+人時間にしました。(model3)
このKMモデルでわかるように、model1(左)とmodel2(中央)は別物です。一方でmodel1とmodel3(右)のグラフは同じであることがわかります。
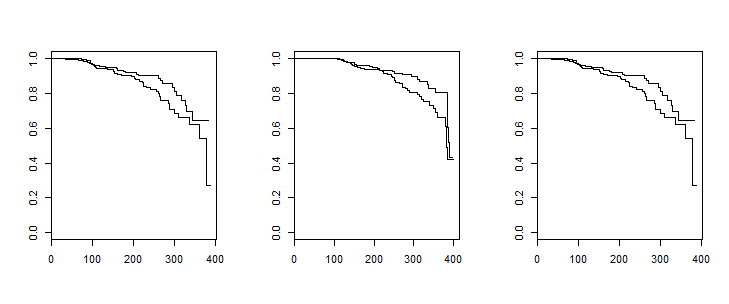 生存解析では、人時間(観察期間)だけでなく、どこからStartしてどこでStopしたかという、該当期間の位置も考慮すべきことがわかります。Stopが105から始まっているmodel2の回帰ではtime = [0-104]までイベントが起きていません。
model1 == model3 != model2ということは、コード中のコックス比例ハザードモデルの結果でもわかります(走らせてみてください)。
時間依存共変量
さて、start とstopという情報が生存解析に重要であることが見えてきたので、ちょっと面倒ですが、今度は、time-varying covariateを含むデータを作って回帰してみます。
# time varying covariate graph
library(dplyr)
set.seed(113)
test=data.frame(id = 1:400,
                baseline= 0,
                smoke  = c(rbinom(400, 1, prob=0.3)),
                treat   = c(rep(0, 200), rep(1, 200)),
                censor  = sample(10:180, 400, replace = T),
                outcome = c(rbinom(200, 1, prob=0.1), rbinom(200, 1, prob=0.2)))
test1 = test %>%
  mutate(visit1 = sample(21:42, 400, replace = T),
         smoke1 = c(rbinom(400, 1, prob=0.3))) %>%
  mutate(visit2 = visit1 + sample(21:42, 400, replace = T),
         smoke2 = c(rbinom(400, 1, prob=0.3))) %>%
  mutate(visit3 = visit2 + sample(21:42, 400, replace = T),
         smoke3 = c(rbinom(400, 1, prob=0.3))) %>%
  mutate(visit1 = ifelse(visit1<censor, visit1, NA),
         smoke1 = ifelse(visit1<censor, smoke1, NA),
         visit2 = ifelse(visit2<censor, visit2, NA),
         smoke2 = ifelse(visit2<censor, smoke2, NA),
         visit3 = ifelse(visit2<censor, visit3, NA),
         smoke3 = ifelse(visit2<censor, smoke3, NA))
test2 = tmerge(data1 = test,  data2=test1, id=id, tstop=censor, event = event(censor, outcome))
test2 = tmerge(data1 = test2, data2=test1, id=id, smoke=tdc(visit1, smoke1))
test2 = tmerge(data1 = test2, data2=test1, id=id, smoke=tdc(visit2, smoke2))
test2 = tmerge(data1 = test2, data2=test1, id=id, smoke=tdc(visit3, smoke3))

# KM plot
## smoking status fixed at baaseline
test$SurvObj1 = with(test , Surv(censor, outcome == 1))
## smoking status varying time
test2$SurvObj2 = with(test2, Surv(tstart, tstop, event == 1))

par(mfcol=c(1,2))
plot(survfit(SurvObj1~smoke, test))
plot(survfit(SurvObj2~smoke, test2))

# Cox hazard model
coxph(SurvObj1 ~ treat + smoke, data=test)
coxph(SurvObj2 ~ treat + smoke, data=test2)
testデータセットではベースラインデータと、打ち切り(センサー)データ、アウトカムを作り、test1では各visitにおける、喫煙の有無の情報を加えました。
さて、test1は1人1行ですが、これを、各visitごとに別々の観察行にしてやります。この操作にはSurvivalパッケージのtmergeを使います。
time2をじっくり見ていただくと、ひとりの人のビジット毎に観察が分けられ、smokeの状況が更新されていること、イベントが起きた場合にのみevent==1となっていることに気づきます。
下記グラフは、喫煙の有無で、層別化したKM曲線で、左がベースラインの情報のみを使ったもの、右が喫煙状態が変化しているのを考慮したものです*1。
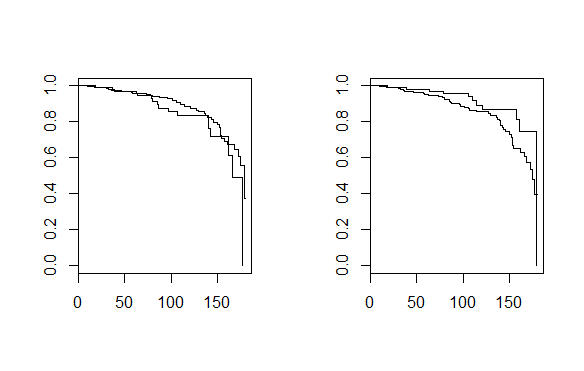
共変量の時間変化を考慮することでグラフの形がかなり変わっています。コックス比例ハザードモデルのパラメータも違うことが上のコードを走らせると確認できます。ただ観察が細切れになっているだけで解析モデルの記述自体は時間共変量を考慮しても考慮しなくても同じであることが分かると思います。
まとめ
時間依存性共変量がある解析は、観察のstartとstopの情報を保持して、一人の人をいくつものオブザーベーションに分割して、その中での共変量の状態を使って回帰していきます。
それ以外のところは通常の回帰と同じです。同じ人が何度もデータに出てくるから独立性は大丈夫なのか!という感じが最初はします。しかし、コックス比例モデルは、ある瞬間のハザード(イベント発生率)に回帰していて、この場合、その瞬間においては症例の重複はないので、問題ないと理解しています。
オブザーベーションを切り分けていくのは自分でやるとかなり面倒ですが、tmergeがあって助かりました。Survivalパッケージのヘルプに、いろいろとtmergeのオプションが紹介されています。
*追記: tmergeの挙動が変わっていて上のコードで上手くtest2ができなくなっています。ちょっとブサイクですが、上記でtestを作ったあとは、下記のようにtest4を作って、使えば動くと思います。
test1 = test %>%
  mutate(smoke0=smoke) %>%
  mutate(visit1 = sample(21:42, 400, replace = T),
         smoke1 = c(rbinom(400, 1, prob=0.3))) %>%
  mutate(visit2 = visit1 + sample(21:42, 400, replace = T),
         smoke2 = c(rbinom(400, 1, prob=0.3))) %>%
  mutate(visit3 = visit2 + sample(21:42, 400, replace = T),
         smoke3 = c(rbinom(400, 1, prob=0.3))) %>%
  mutate(visit1 = ifelse(visit1<censor, visit1, NA),
         smoke1 = ifelse(visit1<censor, smoke1, NA),
         visit2 = ifelse(visit2<censor, visit2, NA),
         smoke2 = ifelse(visit2<censor, smoke2, NA),
         visit3 = ifelse(visit2<censor, visit3, NA),
         smoke3 = ifelse(visit2<censor, smoke3, NA))
test2 = tmerge(data1 = test,  data2=test1, id=id, tstop=censor, event = event(censor, outcome))
test2 = tmerge(data1 = test2, data2=test1, id=id, smoke=tdc(visit1, smoke1))
test2 = tmerge(data1 = test2, data2=test1, id=id, smoke=tdc(visit2, smoke2))
test2 = tmerge(data1 = test2, data2=test1, id=id, smoke=tdc(visit3, smoke3))

test3 = left_join(test2, test1[c('id', 'baseline', 'smoke0')],
                  by=c('id', 'tstart'='baseline')) %>%
  mutate(smoke=ifelse(!is.na(smoke0), smoke0, smoke))
test3 = left_join(test3, test1[c('id', 'visit1', 'smoke1')],
                  by=c('id', 'tstart'='visit1')) %>%
  mutate(smoke=ifelse(!is.na(smoke1), smoke1, smoke))
test3 = left_join(test3, test1[c('id', 'visit2', 'smoke2')],
                  by=c('id', 'tstart'='visit2')) %>%
  mutate(smoke=ifelse(!is.na(smoke2), smoke2, smoke))
test3 = left_join(test3, test1[c('id', 'visit3', 'smoke3')],
                  by=c('id', 'tstart'='visit3')) %>%
  mutate(smoke=ifelse(!is.na(smoke3), smoke3, smoke))
test4 = test3 %>% select(id, treat, tstart, tstop, smoke, event)

# KM plot
## smoking status fixed at baaseline
test$SurvObj1 = with(test , Surv(censor, outcome == 1))
head(test)
## smoking status varying time
test4$SurvObj2 = with(test4, Surv(tstart, tstop, event == 1))
head(test4)

par(mfcol=c(1,2))
plot(survfit(SurvObj1~smoke, test))
plot(survfit(SurvObj2~smoke, test4))

# Cox hazard model
coxph(SurvObj1 ~ treat + smoke, data=test)
coxph(SurvObj2 ~ treat + smoke, data=test4)
*1:time-lagは考慮していません
Rの論理判定は欠損値があるときには注意
解析に回す前にデータクリーニングなどを行いますが、 欠損値があるときにAndやOrなどの演算子を使うと、 予期せぬ挙動をすることがあります。 RのNAの処理の仕方が、かなり我々の印象と違います。
例 (irisデータで)
test = iris
test[sample(1:nrow(iris),60, replace=T),1] = NA
test[sample(1:nrow(iris),60, replace=T),2] = NA
上記でランダムに欠損したデータを作ります。 まず、Andについてみてみます。
data.frame(col1=test[,1] > 5, col2=test[,2] > 3,
A= test[,1] > 5 & test[,2] > 3,
Product= (test[,1] > 5) * (test[,2] > 3)==1)
結果はランダムに変わりますが、例えばこうなります。
   col1  col2    And  Product
1  TRUE TRUE    TRUE     TRUE
2    NA   NA      NA       NA
3 FALSE   NA   FALSE       NA
4 FALSE TRUE   FALSE    FALSE
5    NA TRUE      NA       NA
6  TRUE   NA      NA       NA
3行目3列目に注目していただくと、普通の&でつないだだけの論理演算子は、
FALSE & NA = FALSE
となっていますが、 直感的にはどちらかがNAであれば結果もNAに
なってほしいところです。
ifelseなどのif文でこのようなデータ処理をしがちで危険です。
この場合、4列目のように掛け算を使うことで回避できます。
一方、Orの演算子|については、
data.frame(col1=test[,1] > 5, col2=test[,2] > 3,
 Or= test[,1] > 5 | test[,2] > 3,
 Add= (test[,1] > 5) + (test[,2] > 3)>0)
の結果は下記になります。
   col1    col2     Or     Add
1  TRUE    TRUE   TRUE    TRUE
2    NA      NA     NA      NA
3 FALSE      NA     NA      NA
4 FALSE    TRUE   TRUE    TRUE
5    NA    TRUE   TRUE      NA
6  TRUE      NA   TRUE      NA
こちらでは、5行目や6行目のように、
NA | TRUE = TRUE
となってしまいますが、これはこれで良いこともあります。
(どちらかでもTRUEならもう片方がNAでも良い)
加法を使うことで厳密な結果を返すようにもできます(4列目)。
結論
NAを多く含むデータでは &は使わない。|は状況次第
と心がけています。*1
Irisデータで勾配ブースティング
実際にxgboostを使用して、Gradient Boostingをしてみます。 今回は、Irisデータを7:3にトレーニングとテストに分けて、XGboostをやってみます。
Petal.Widthがデータ平均以下/以上の予測を行うことにします。
とりあえず、R上で下記を走らせてみます。
# Preparation ##################################
# rm(list=ls())
# setwd("~/")
library(dplyr)
library(data.table)
library(xgboost)
library(caTools)
library(Matrix)
library(verification)

# load iris
dt = data.table(iris)

# Dichotomize Petal Width, split data ###########
dt[, Petal.Width:= ifelse(Petal.Width > mean(dt$Petal.Width), 1, 0)]
lab  = dt$Petal.Width # label
set.seed(123)
split= sample.split(lab, SplitRatio = 0.7)
sm   = sparse.model.matrix(Petal.Width~.-1, data=dt)
sm1  = sm[split == T,] ; lb1 = lab[split == T] # train
sm2  = sm[split == F,] ; lb2 = lab[split == F] # test

# XGB boosting
classifier = xgboost(data = sm1, label = lb1, nrounds = 5, objective = 'binary:logistic')
importance <- xgb.importance(feature_names = colnames(sm1), model = classifier)
importance2  <- xgb.importance(feature_names = colnames(sm1), model = classifier)
xgb.plot.importance(importance_matrix = importance2)

# ROC
pred = predict(classifier, newdata = sm2)
roc.plot(lb2, pred, legend=T)

# Confusion matrix
pred2 = (pred >= 0.5)
table(lab[split==F], pred2)

# See the data structure
plot(iris$Petal.Length, iris$Petal.Width)
importanceは各変数をどのポイントで分けると分離が良いかを示しており、importance2はそれを変数ごとにまとめたものです。
ここでは、Petal.Lengthのみで、Petal.Widthの大/小をほぼ分けられています。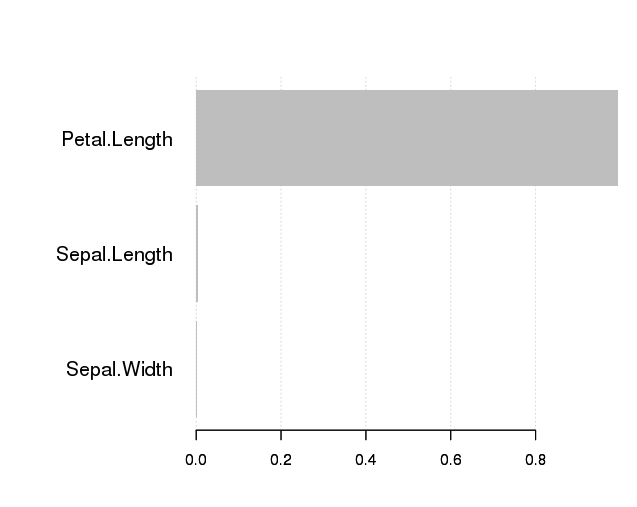
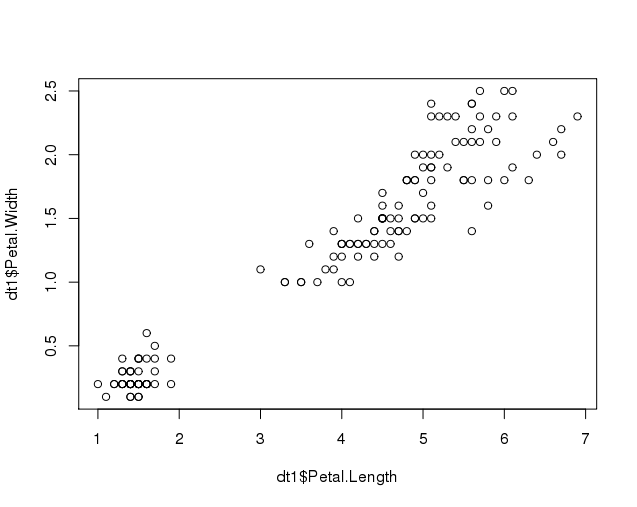
これは、下記のように、Petal.WidthとPetal.Lengthがとても強い相関を示していることから理解できると思います。
ROCとConfusion matrixは、テストデータでのモデル性能がとても良いことを示しています。
これでは、面白くないので、Petal.Lengthを消してみて、同じことをしてみます。
# Erase Petal.Length
dt[, Petal.Length:=NULL]
sm = sparse.model.matrix(Petal.Width~.-1, data=dt)
sm1  = sm[split == T,] ;  # train
sm2  = sm[split == F,] ;  # test

# XGB boosting
classifier = xgboost(data = sm1, label = lb1, nrounds = 10, objective = 'binary:logistic')
importance <- xgb.importance(feature_names = colnames(sm1), model = classifier)
importance2  <- xgb.importance(feature_names = colnames(sm1), model = classifier)
xgb.plot.importance(importance_matrix = importance2)

# Prediction
pred = predict(classifier, newdata = sm2)
roc.plot(lb2, pred)
pred2 = (pred >= 0.5)
table(lab[split==F], pred2)
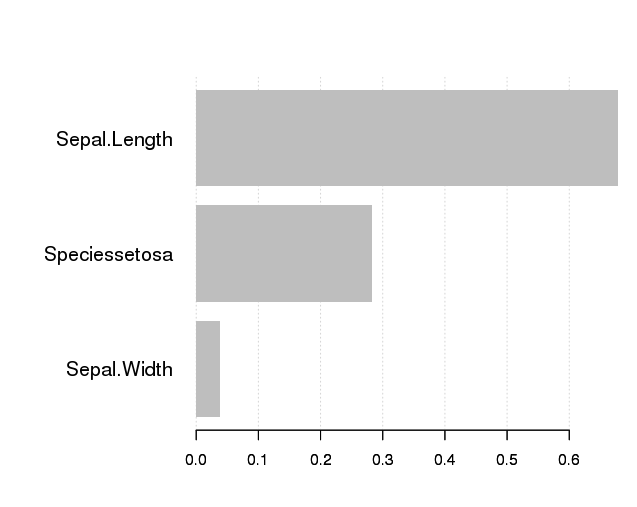
今回は、Speciesの違いも説明変数に入ってきました。
最後に、xgboostでは、
classifier = xgboost(data = sm1, label = lb1, nrounds = 10, objective = 'reg:linear')
とObjectiveを変えることで、直線回帰もできるようです。
ロジスティック回帰の変数選択はちょっと違う
多変量回帰において、どれが有効なモデルか
わからないときに、なんでもかんでも、とにかく
変数を突っ込んでみて、有意だったら残すという
アプローチがあります(e.g. ステップダウン、
ステップワイズ等)。
良い予測モデルを得るのが目的の場合には
上記のやり方で問題ないのですが、
特定の要因(暴露因子)がアウトカムに
どう影響を与えているかを調べたいときには
盲目的な変数選択には注意が必要です。
さて、今AとYの関係に興味があるとします。
また、ZはAとは無関係にYに関連する
予測因子とします。
Yが線形の時に下記の2つのモデルを検討します。
モデル1:E(Y|A, Z) = intercept + b1*A + b2*Z
モデル2:E(Y|A) = intercept + b1*A
ここで、式1のZを落とすと、
モデル3:E(Y|A) = intercept + b1*A + b2*E(Z|A)
ZとAは関係がなく、E(Z|A)=定数ですので、
モデル2と3のb1は同じとなります*1。
つまり、Zをモデルに入れようが入れまいが、
b1は二つのモデルで変わりません。
次にYが0.1である場合を考えます。
ロジスティックモデルでは上記モデルの左辺が
それぞれ次のようになります。
モデル1:log(E(Y|A,Z) / (1-E(Y|A,Z))
モデル2:log(E(Y|A) / (1-E(Y|A))
この時モデル1と2は線形の関係にありませんので、
Zを入れることでb1が変わってきてしまいます。
AとZは関係ないので、Aの与えるYへの影響の
不偏推定はモデル2のb1となります。
ロジスティックモデルでの因果推論は、
調整因子をよく考えて選択する必要がありそうです。
*1:その分interceptは変わります
